时序分类是时序分析里面非常重要的分支,基于历史观察的序列信号对样本做出分类。很多现实生活的应用都属于这一类型,比如基于心电图或脑电图对病人病症进行分类,基于传感器数据来区分不同的人体行为动作,基于不同探测器收集的信号来判断仪器未来一段时间是否会出故障。
数据格式
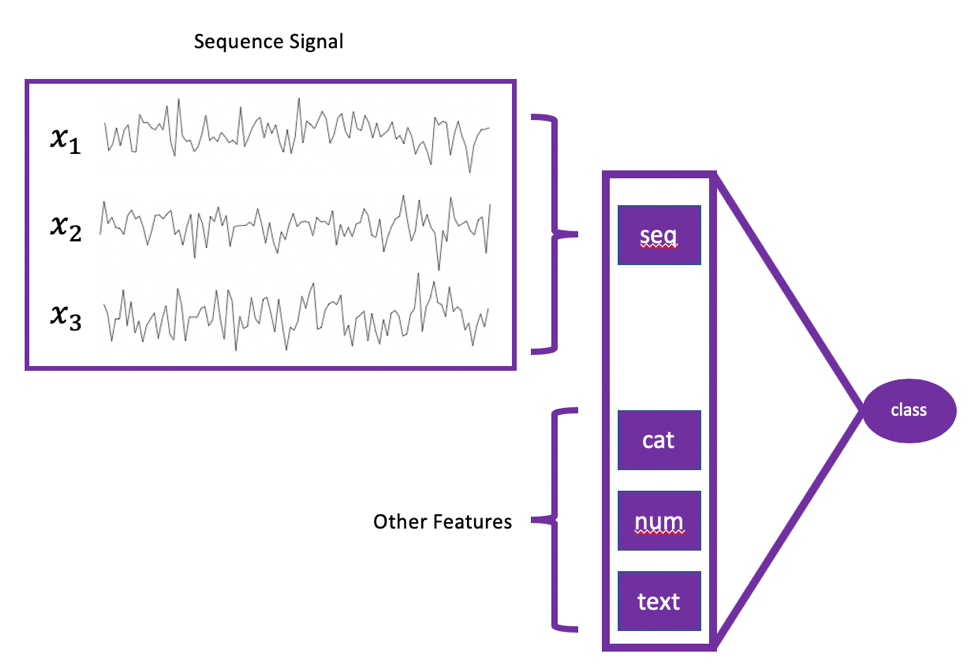
平台目前在分类任务上可以支持用户提供时序数据来进行分类问题。通常,时序分类数据可以可视化为图一:
图一:时序分类数据常见形式
基于上面的数据形式,平台需要准备两个文件来支持时序的特殊格式:
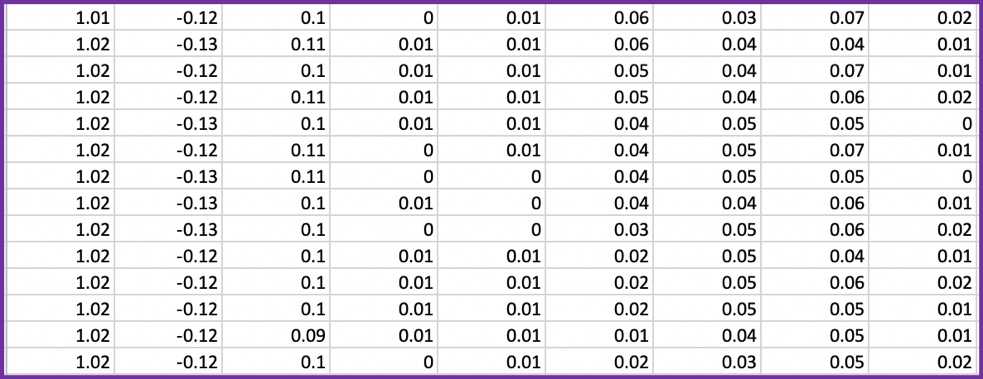
- 将每个样本的时序信号存为一个单独的文件,文件不需要表头,推荐以逗号分隔不同的序列值。例如时序信号有三个分量,时间长度为128步,那么这个信号会以一个128行,三列的文件存放,每一行代表在该步的三个序列的观测值;
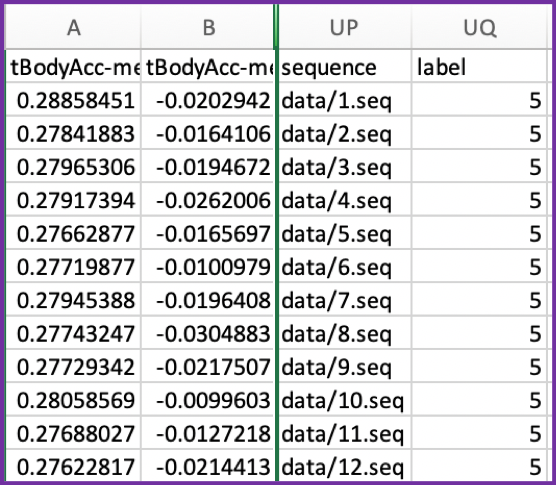
- 其他特征和真实的目标列放在另外一个csv文件里面,另外需要在csv加入额外的一个列来代表序列信号所对应的文件。
任务示例
我们以UCI的开放数据集(人体姿势识别)作为一个演示:https://archive.ics.uci.edu/ml/machine-learning-databases/00240/。该该数据包含了30位自愿者在六种不同的活动中(走,下楼梯,爬楼梯,坐,站立,躺)的传感器测量数据。测量数据来自于自愿者腰中的智能手机的加速计和陀螺仪的九个观测值,观测值以50Hz频率采样。另外,数据提供者根据九个序列生成了561个统计值。数据更详细的描述可以参考上面链接。
基于原始数据,我们需要准备两个文件:
- 一个csv文件包含561个统计值以及目标值和九个序列所在的文件的路径;
- 一个文件夹包含所以样本的九个序列的测量值,每个文件包含128行,9列,文件必须以“seq”作为后缀名,这是平台识别序列数据的格式。
代码实例
- 去数据链接下载原始数据。
- 解压文件,进入到解压后的文件夹,创建“data”和“test_data”两个文件夹。
- 执行下面代码创建平台所需的数据格式
import numpy as np
def load_file(filepath):
dataframe = pd.read_csv(filepath, header=None, delim_whitespace=True)
return dataframe.values
def load_group(filenames, prefix=”):
loaded = list()
for name in filenames:
data = load_file(prefix + name)
loaded.append(data)
# stack group so that features are the 3rd dimension
loaded = np.dstack(loaded)
return loaded
def load_dataset(group, prefix=”):
filepath = prefix + group + ‘/Inertial Signals/’
# load all 9 files as a single array
filenames = list()
# total acceleration
filenames += [‘total_acc_x_’+group+’.txt’, ‘total_acc_y_’+group+’.txt’, ‘total_acc_z_’+group+’.txt’]
# body acceleration
filenames += [‘body_acc_x_’+group+’.txt’, ‘body_acc_y_’+group+’.txt’, ‘body_acc_z_’+group+’.txt’]
# body gyroscope
filenames += [‘body_gyro_x_’+group+’.txt’, ‘body_gyro_y_’+group+’.txt’, ‘body_gyro_z_’+group+’.txt’]
# load input data
X = load_group(filenames, filepath)
# load class output
y = load_file(prefix + group + ‘/y_’+group+’.txt’)
return X, y
def save_sequence_file(folder, X_seq):
# X_seq is [n_samples, time_steps, n_signal] array
sequence = []
for i in range(train_X.shape[0]):
filename = folder + ‘/’ + str(i+1) + ‘.seq’
sequence.append(filename)
x_seq = train_X[i, :, :]
np.savetxt(filename, x_seq, delimiter=",", fmt=’%1.2f’)
return sequence
# load feature name file
features = pd.DataFrame(load_file(‘features.txt’), columns=[‘index’, ‘feature_names’])
# load 561 statistical features
X_train = load_file(‘train/X_train.txt’)
X_train = pd.DataFrame(X_train, columns=features[‘feature_names’].values)
train_X, train_y = load_dataset(‘train’, ”)
sequence = save_sequence_file(‘data’, train_X)
# save train to dataframe
train = X_train.copy()
train[‘sequence’] = sequence
train[‘label’] = train_y[:, 0]
train.to_csv("human_activities_recognition_train.csv", index=False)
# process test
X_test = load_file(‘test/X_test.txt’)
X_test = pd.DataFrame(X_test, columns=features[‘feature_names’].values)
test_X, test_y = load_dataset(‘test’, ”)
test_sequence = save_sequence_file(‘test_data’, test_X)
test = X_test.copy()
test[‘sequence’] = test_sequence
test[‘label’] = test_y[:, 0]
test.to_csv("human_activities_recognition_test.csv", index=False)
- 选中“csv”和“data”文件夹,右键压缩为一个文件,对human_activities_recognition_test.csv”和“test_data”做相同的操作。
- 将步骤4得到的两个压缩文件上传到平台创建模型和测试。
文件示例
截图一是训练数据中的csv文件,截图二是其中一个序列文件。
图二:csv文件截图
图三:序列文件截屏
注意事项
- 序列中目前只支持数值特征
- 如果不同的序列长度不同,我们后台会自动处理这种情况