数值预测,也叫做回归——使用训练数据来预测一个或多个连续数值型变量。例如,回归模型做出的预测可回答如下问题:
- 上海一栋房产的价值是多少?
- 用户点击此广告的概率是多少?
回归案例:
为了演示如何创建回归模型,我们使用Boston housing dataset。为简化起见,对原数据稍作了修改,
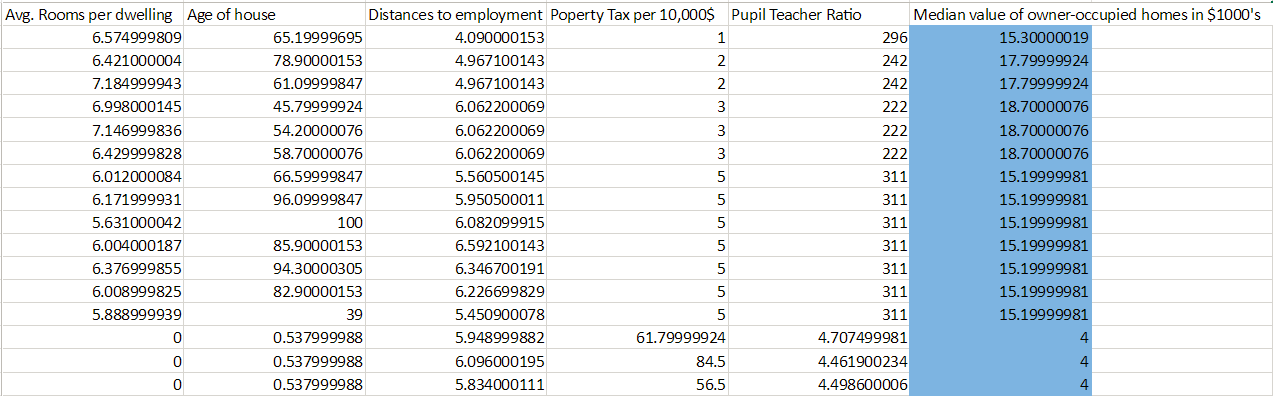
在这个例子中,我们将根据不同的特征(房龄、房产税、房间数等)来预测房屋价值。我们要预测的变量(蓝色部分所示)是房屋的中位数价格。
上传数据和选择任务类型及目标变量之后,我们必须选择一个评价模型的指标:
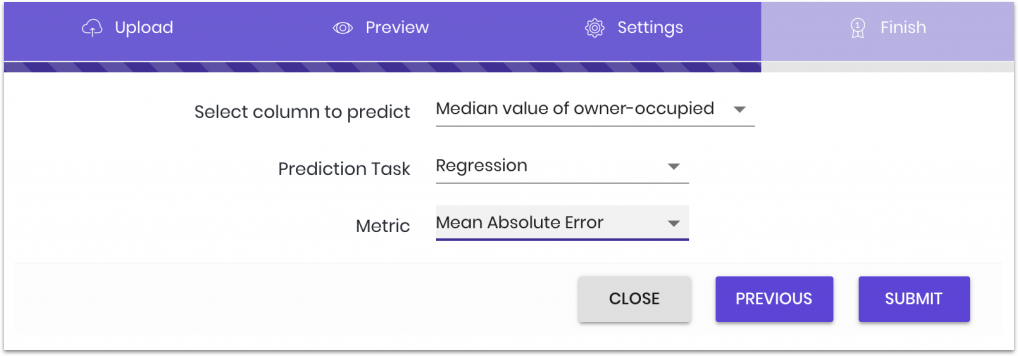
平台提供多个模型指标,而最重要的是选择最合适的指标以助于评估出最好的模型。
指标
根据您的业务需要,选择合适的指标。平台现在提供了三种不同的指标:均方根误差,平均绝对值差异和百分比误差,这三个指标是在预留的20%的数据里计算出来的,这20%的数据不会在训练模型期间使用,仅仅用于评判不同模型的好坏。
回归任务支持的三个指标:
- RMSE(均方根误差):预测值与真实值的平方差异的平均值的平方根。
- MAE(平均绝对误差):预测值与真实值的绝对值差异的平均值。
- MAPE(平均绝对百分比误差):预测值与真实值的绝对百分比差异的平均值。
一般来说,我们推荐MAE作为回归分析的首选指标。这主要归因于MAE是最容易解释的,同时对于数据中较大值(异常值)不敏感。
RMSE因为计算的是平方差异,因此对异常值极其敏感。如果所关心的场景是需要准确预测数据中较大的数值,推荐使用RMSE,因为RMSE会对这些异常 值给予较大的惩罚,使得模型更加关注于预测中的这些样本。
当你的数据值域跨度特别大,并且希望预测值与真实值在一定的百分比以内,MAPE则是非常有用的。MAPE对预测值本身大小并不关心,不论是0.01还是1000,MAPE都尝试让模型预测结果在真实结果的固定百分比以内。因此,MAPE会更加关注于预测数值较小的样本,因为0.01的百分之十只允许预测值与真实值偏差0.001,而1000则允许有100的差异。
何时使用回归?
简言之:当需要预测连续性数值数据,比如房价,或是产品成本时,使用回归。当要预测的目标是一些离散的类别,比如狗的不同种类,不同的服装品牌等,使用分类。
广告点击率(CTR)预测是一个例外。对任何广告,我们可以在训练数据里计算出该广告被点击的概率(#总点击次数/#总显示次数),这样我们会得到一个在0-1之间的连续数字作为预测目标。但实际上这是一个分类问题。因为连续数字的输出是一个二元选择的概率问题(点击或者不点击),在这种情况如果选择二分类模型会给出概率预测。一般而言,当你需要预测事件发生的概率的时候,推荐使用二分类。