本概述将涵盖使用OneClick.ai时需要考虑的核心概念以及OneClick.ai与真实商业问题之间的关联。
我们将使用来自UCI Archive 的“Dress Recommendation” 数据集,为适应演示格式,我们已对其进行了些许修改。
“一家礼服店正在试图确定未来要储存的服装,以充分利用其有限的存储空间并实现最大化销售。 他们收集了已出售的礼服裙数据,并根据销售额及其他品质确定了哪些连衣裙值得存储。 现在他们有了新的礼服可供选择,并且需要一个AI模型帮助预测,从而选择最有价值的礼服进行存储。”
数据
这个例子中使用到的数据集包含关于之前的礼服的各种特征以及当时存储建议的信息(通常这些信息可以在历史数据中收集,而是否推荐的信息可以通过人工简单的标注):
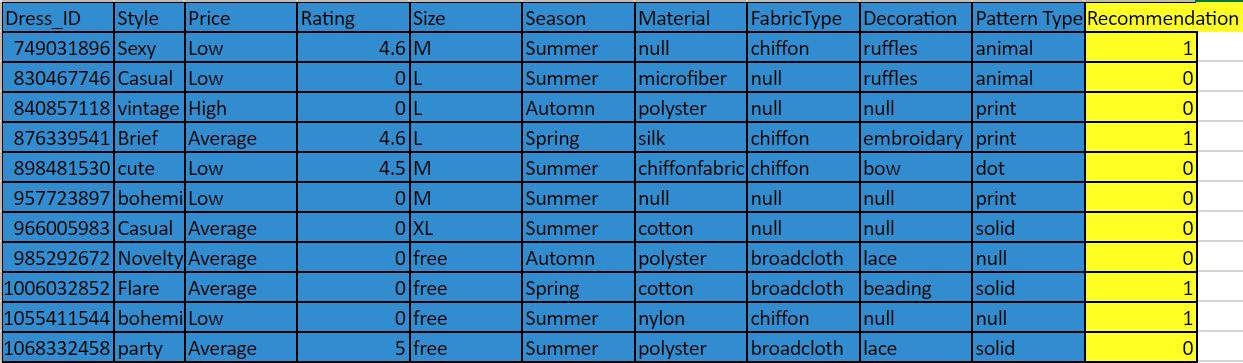
我们在用于模型训练的数据集中寻找几种不同形式的分类:
特征:(以蓝色显示)也叫自变量,独立变量。是有助于预测的数据。 数据应尽可能多样化和详尽。在该示例中,我们尽可能提供了决定衣服销售的关键因素:尺寸大小、衣服款式、用户评价、季节、衣服材质等。不同的任务可能需要的特征不尽相同,如果您不确定需要提供什么样的信息,欢迎咨询我们,我们会为您必要的建议。
- AI模型通过这些特征来识别数据中的潜在模式,因此确保这些信息和需要预测的标签相关是非常重要的。 如果信息缺失或者缺少关键信息都会导致模型准确率不高。
- 例如,由于通常来说中等尺码要高于大尺码或者小尺码衣服,如果在该示例数据中“服装尺寸”缺失,那么模型就很难区分不同尺码的备货情况。
标签: (以黄色显示)也叫因变量,控制变量等这是我们需要预测的列,比如简单线性回归中的y变量。 标签可以是小麦未来的价格、图片中显示的动物品种、音频剪辑中的含义或任何事务。由于我们采用监督学习的方式(在训练模型的时候提供正确的标签从而让AI模型发现标签和特征的规律),所以上传到平台的训练数据需要包含每个样本的正确的标签。
“所有的数据集在上传之前都必须转换成CSV/TXT/TSV或者这些格式文件的压缩文件(ZIP/GZ/TAR/RAR),另外,对于更加复杂的数据格式,还有其他情况需要考虑,关于格式化数据的更多信息,请点击.”
创建任务
现在我们就可以使用这个数据集来训练AI模型,并基于销售潜力为店铺管理人员推荐礼服裙。

点击上传数据按钮后,系统会要求您上传数据,通过拖拽或者文件预览查找文件即可完成:
一旦数据上传,您就可查看数据(注意:为了用户体验,我们仅显示数据的前100行):
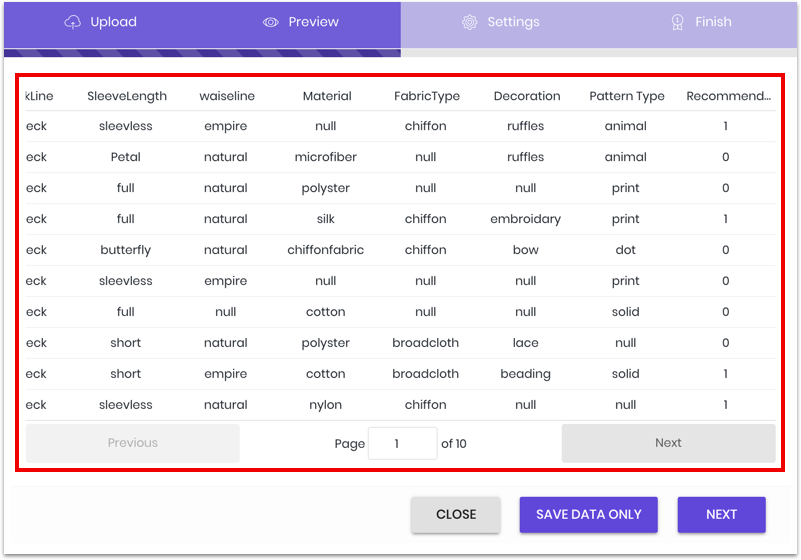
- 查看数据: (红色方框) 确保数据没有显示错误。您在当前窗口所看到的数据会以同样的格式输入到模型中,如果有显示错误,可能会导致模型见到错误的信息。
数据上传和检查完成后,任务参数设置如下:
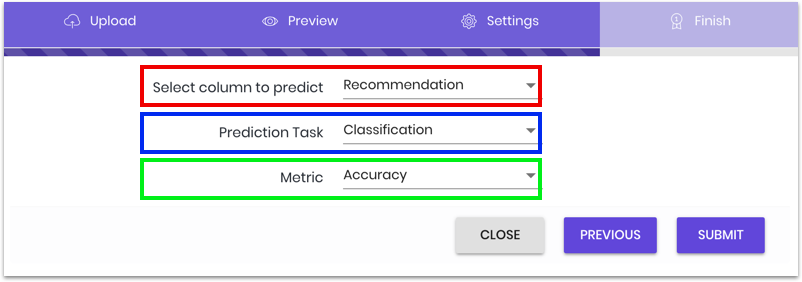
训练AI模型,我们需要指定上图标示的三个信息:
- 预测列: (红框) 选中您所选的标签列,这是模型训练的目标。
- “推荐”栏作为标签,所以被选为预测列。
- 任务: (蓝框)任务类型:目前可选拟合,分类,时序预测。
- “分类”用于离散值(二分类或多分类),对于推荐系统,我们可以转成为分类问题(推荐或者不推荐)。
- 指标: (绿框) 选择评价指标有助于根据您最看重的指标评估模型,这会是系统尝试优化的目标(尽可能减少或者增加这一指标的值)。 这里选择的所有指标都是用来衡量模型“准确度”的方法,对于这项任务,所选择的“准确度”指标包括模型在所有预测中做出正确预测的概率。
- 因为销售决策依赖于模型的预测,我们需要一个尽可能进行正确推荐的模型,因此,我们可以选择准确度作为评估模型质量的指标。
指标依赖于学习任务的类型,关于其他可用的学习任务和指标,请参照文档:分类 和回归
模型训练和测试
训练、测试和创建模型的过程完全实现自动化。取决于AI需要学习的数据的类型和数据大小,这个过程可能需要几分钟到几天的时间。
一旦任务提交成功,您可以通过模型界面查看模型训练的进展:
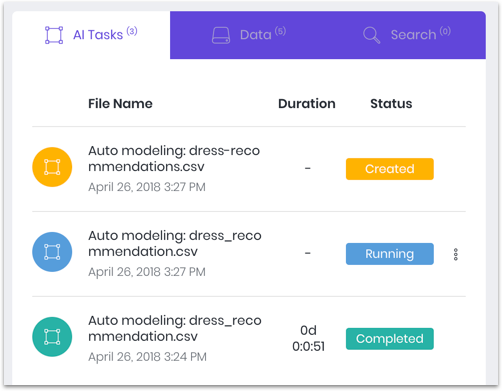
欲知更多关于建模过程的详情,点击任务名称即可。
检查模型
模型训练完成以后,就能查看和选择最好的模型:
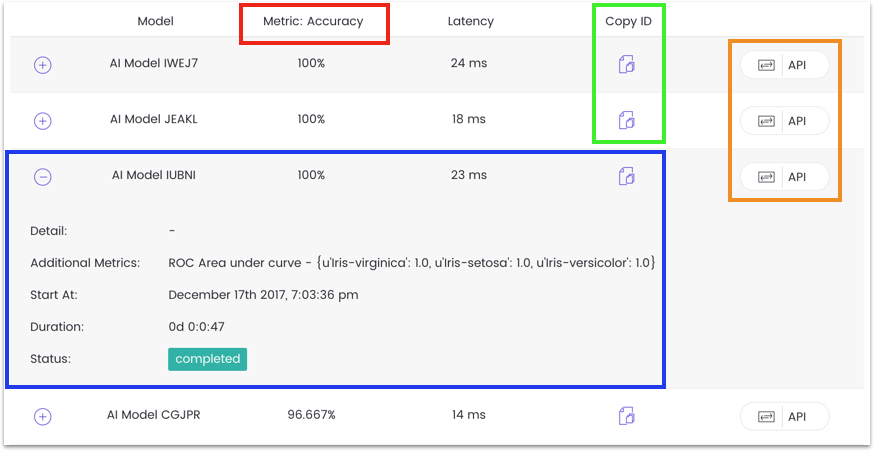
在此屏幕上,可以根据之前设置的指标查看和选择模型。注意的要点是:
- 关键指标: (红框) 这是预先选定的“重要”指标,最能反映模型的好坏。
- 详细信息: (篮筐) 这是某个模型的其他细节,包括其他供参考的指标以及模型的总共训练时间等。
- 复制 ID: (绿框) 这是模型的ID,可以复制该ID来在对话框中进行其他操作,比如查看ROC曲线,启动批处理预测任务等。
- API 导出: (橙框) 如果模型需要被发布到在线系统中,点击该按钮就可以讲模型以API的形式发布。(有关API的更多信息请点击)
选择模型后,最后一步是应用模型并进行预测。
发布
当前系统支持两种发布模型的方式:
- 使用ai的内置命令将模型以批处理的方式对测试数据进行预测。
- 启动实时API功能,供其他程序调用。
内置命令使用我们的聊天机器人“Eva”来运行,关于使用‘Eva’的关键信息如下:
- 聊天窗口: (红框) 这里显示了和Eva的聊天记录,这个在后面也能进行查看。这是显示和下载预测结果的位置。
- 指令框 : (蓝框)这里是对Eva输入对话的位置,所有的指令都以”@Eva“开始。
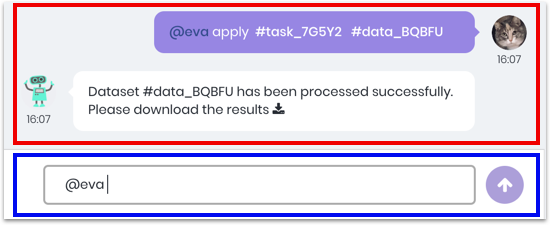
在这种情况下,作为指令的“apply model #task_id/#model_idto #data_id”命令(显示在红色框中),将会自动将选定的模型应用于指定的数据集上。
点击任务和数据右侧下拉菜单就能找到任务和数据ID ,如果想使用特定模型的ID,可从模型列表中获取。
一旦批处理预测结束,您就可以点击下载链接下载预测文件(如下图所示,这里只截取了部分结果并高亮了不同的列):
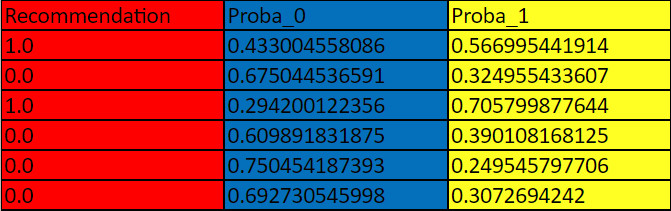
此处有三个不同的列,每列代表了是否要存放某些连衣裙的关键信息:
- 推荐建议: (红框) 关于是否存储某一款裙子的建议由1(是)和0(不)表示。
- 阈值:决定最后是否推荐产品备货的值,对于该问题,这个阈值在0到1之间,如果阈值为5,那么只要推荐的概率大于0.5,我们就选择备货,否则就不备货该产品。选择的阈值越高,所推荐的产品数据也越少,但我们对推荐的结果正确性把握也越大。关于如何选择阈值,可以查看分类文档。
- “否”(不推荐)的概率: (蓝框) 本栏显示模型基于该样本信息做出不推荐的概率(概率越高,模型越倾向于不推荐该产品)。
- “是”(推荐)的概率: (黄色栏) 本栏显示模型基于该样本信息做出推荐的概率(概率越高,模型越倾向于推荐该产品)。
有些场景需要预测结果是概率值,如第二和第三列。这样您可以用不同于默认为50%的阈值去预测类别。
虽然第一行显示1,也就是推荐库存礼服。但从概率分析仍有43%的可能,它不应该去推荐。这些信息在实际场景中,用户需要充分考虑和权衡。
如果商家发现目前存储空间不足,可以用高于50%的阈值(如60%)去决定是否库存礼服。这样原本第一行的推荐库存的决定会变成不推荐。
当然如果存储空间有很多的话,也可以使用低于50%的阈值。
摘要
感谢您抽出宝贵时间熟悉OneClick.ai的产品以及如何使用它来预测可能的业务场景。现在您可以:
- 快速上手,即便没有任何AI的技术
- 在几分钟内建立了过去需要几天的时间的AI
- 将人工智能技术实实在在地运用到您的各种业务场景里,产生商业价值。